Dokładny model AI może zawieść w szpitalu. Decyduje droga jego wyniku
Wysoka czułość czy trafność modelu AI nie wystarczają, by uznać go za bezpieczny w opiece klinicznej. Liczy się także, czy jego wynik zostanie zauważony, sprawdzony i właściwie wykorzystany przez ludzi oraz system pracy, a bezpieczeństwo trzeba oceniać w realnych warunkach i monitorować po wdrożeniu.
Metryka mówi o modelu, nie o całej ścieżce pacjenta
Autorzy artykułu opublikowanego 14 września w „Frontiers in Artificial Intelligence” wskazują, że czułość, swoistość, kalibracja i dokładność w benchmarku są potrzebne do oceny narzędzia. Opisują jednak jego działanie w zdefiniowanych warunkach testu, a nie pełne bezpieczeństwo kliniczne.
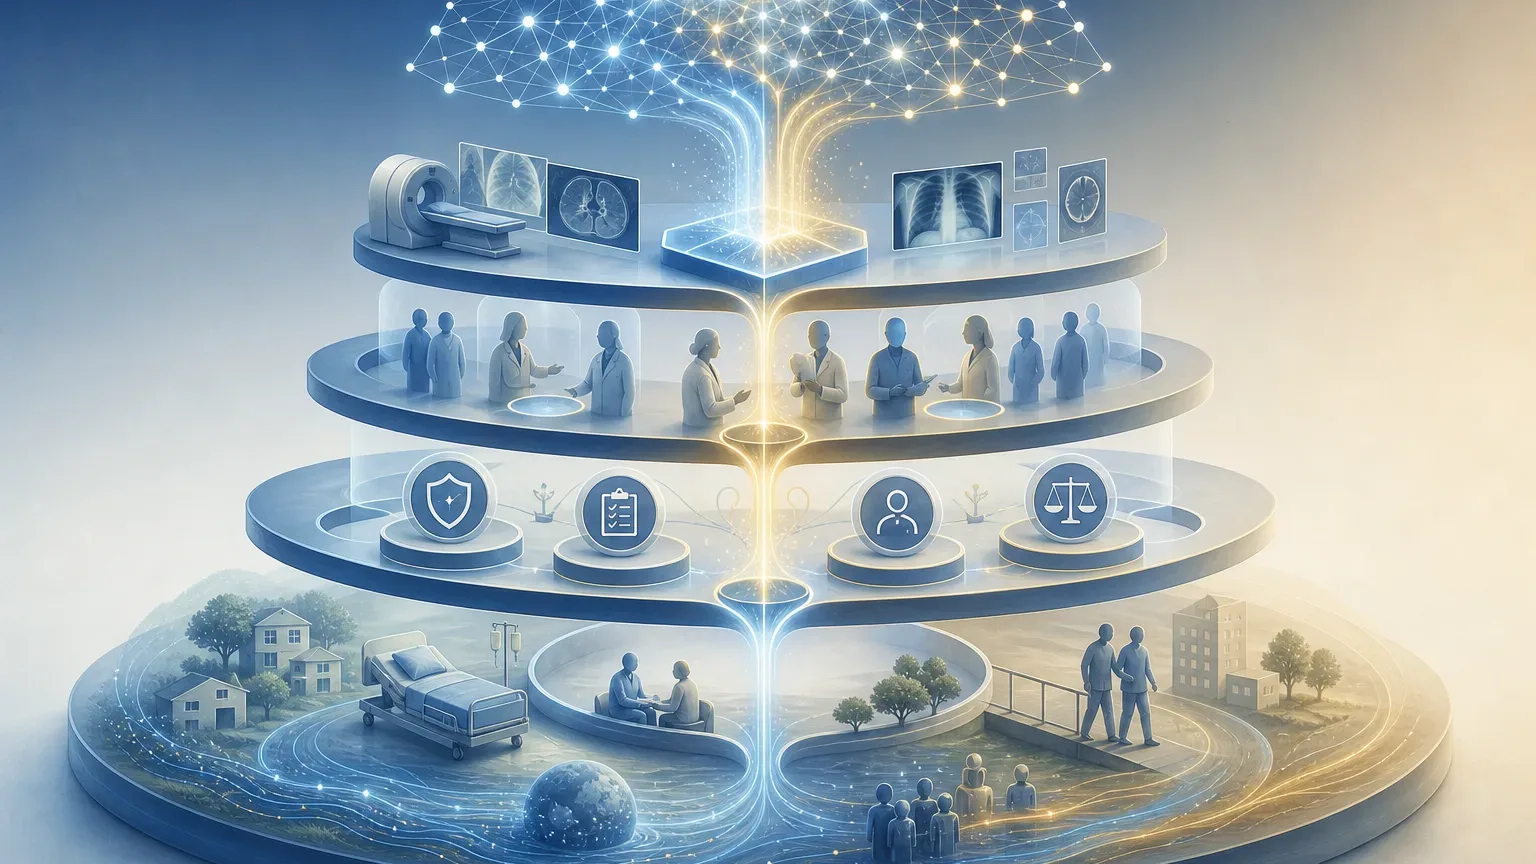
Po wdrożeniu wynik algorytmu trafia do sekwencji decyzji podejmowanych przez ludzi i organizację. Personel musi go zobaczyć, ocenić, zdecydować, czy mu zaufać, ewentualnie zweryfikować, a następnie podjąć działanie. Każdy z tych etapów może zmienić praktyczny skutek rekomendacji AI.
Błąd algorytmu i szkoda dla pacjenta to nie to samo
Publikacja rozdziela błąd modelu od szkody dla pacjenta. Fałszywie dodatni wynik może zostać zauważony i skorygowany, zanim wpłynie na leczenie lub dalszą diagnostykę. Sam błąd techniczny nie przesądza więc o negatywnym skutku.
Działa to także w drugą stronę. Technicznie poprawna rekomendacja nie gwarantuje bezpieczeństwa, jeśli na przykład przeciąża ścieżkę skierowań albo zachęca użytkowników do zbyt bezkrytycznego polegania na systemie. Ocena powinna zatem obejmować nie tylko to, czy model odpowiada poprawnie, lecz także co dzieje się z odpowiedzią w codziennej pracy.
Po uruchomieniu warunki mogą się zmienić
Amerykańska FDA zwraca uwagę, że działanie systemów AI w praktyce może zmieniać się wraz z danymi wejściowymi, populacją pacjentów, praktyką kliniczną i infrastrukturą. Znaczenie ma również sposób włączenia narzędzia do organizacji pracy oraz zachowanie jego użytkowników.
Agencja używa pojęcia „data drift” wobec zmian danych, ale także zmian warunków użycia, praktyki czy populacji. Taki dryf może obniżać skuteczność systemu, zwiększać stronniczość lub osłabiać jego wiarygodność. To problem, którego jednorazowy wynik z testu nie musi wychwycić.
Benchmark jest punktem startu, nie końcem oceny
FDA zaznacza, że testy retrospektywne i statyczne benchmarki dają użyteczny punkt odniesienia, ale nie są projektowane do przewidywania działania AI w zmiennym środowisku rzeczywistej opieki. W dokumencie będącym prośbą o komentarze agencja wskazuje na potrzebę systematycznego monitorowania systemów po wdrożeniu.
To nie jest porównanie konkretnych produktów ani miara częstości szkód związanych z AI. Artykuł z „Frontiers” proponuje ramę analizy ryzyka. Wspólny wniosek obu źródeł jest jednak praktyczny: bezpieczeństwo kliniczne trzeba oceniać w warunkach rzeczywistej opieki, na poziomie całego systemu — modelu, ludzi i warunków, w których wspólnie działają — a po wdrożeniu systematycznie monitorować.
Źródła